昌维的思维链 — Practical notes on AI, systems, and engineering
Loading home content
Loading home content
Technical notes, tutorials, and reflections.
Loading article list
Categories
Tags
Loading article content

这是 AI 系列的第三篇。前两篇分别聊了 AI 的发展脉络和机器学习基础,这篇换个问题:ChatGPT 这类模型到底是怎么被「训」出来的?为什么预训练完还不能直接上线,非要做 SFT 和 RLHF 对齐?最后我会用 fine-tuning-playground 在本地 GPU 上跑一遍 QLoRA 监督微调,让 Qwen3.5-4B 学会回答台师大的问题。
不需要你训过大模型,但最好有基本 Python 环境,愿意打开终端跟着敲命令。
你可能已经用过 ChatGPT、Claude、Gemini 或通义千问。它们能写邮件、改代码、解释概念,语气往往礼貌、结构清晰,像一个训练有素的助手。2022 年底 ChatGPT 发布之后,「大语言模型」从科研对象迅速变成 消费级产品——背后不仅是参数变大,更是 训练范式 的成熟:先预训练,再 SFT,再 RLHF。OpenAI 后续 GPT-4、o 系列在架构与数据上继续迭代,但 对齐流水线 的逻辑一脉相承。
但如果你只把「大语言模型(Large Language Model,LLM)」理解成「读了互联网上所有文字的超级 autocomplete」,就会漏掉一半故事:产品级的对话 AI,几乎都不是「预训练完就上线」的。
预训练教会模型「语言是什么」——语法、事实片段、写作风格、代码模式。它不会天然知道:用户问一个问题时,应该直接回答,而不是续写一篇 Wikipedia;应该简洁,而不是写三千字散文;应该承认不知道,而不是自信地编造。这些「当好助手」的能力,来自后续的对齐(Alignment)阶段:监督微调(Supervised Fine-Tuning,SFT) 与 基于人类反馈的强化学习(Reinforcement Learning from Human Feedback,RLHF)。

本文路线图如下:
ntnu_dataset.jsonl(约 1,252 条师大问答)。AI 入门 建立了 函数视角 与 Transformer 位置;MNIST 实战 带你走过 损失函数、反向传播、epoch 与 train/test split。本文把同一套「用数据塑形行为」的思路搬到 十亿参数语言模型 上:预训练权重是起点,SFT 数据集是你给模型上的「专业课」。

现代 ChatGPT 类助手,背后通常是一条多阶段训练流水线。OpenAI 在 InstructGPT 论文(Ouyang et al., 2022)中把这条路线讲得很清楚:先用海量文本做预训练,再用人类示范做 SFT,再用人类比较训练奖励模型,最后用强化学习把策略推向「人类更喜欢的回答」。Anthropic、Google、Meta 等厂商的 Claude、Gemini、LLaMA 系列产品在公开材料中同样强调 post-training 阶段的重要性——细节各异,但 「基座 + 对齐」 二分法已成为行业语言。下面按 InstructGPT 四步顺序展开,便于你对照任何一家厂商的技术博客阅读。
2018  GPT-1        预训练 + 任务 fine-tune 范式确立
2019  GPT-2        更大模型、零样本能力引发关注
2020  GPT-3        少样本 prompting,仍主要是 base LM
2022  InstructGPT  SFT + RLHF,小模型胜大 base
2022  ChatGPT      消费级 instruct 产品化
2023+ GPT-4 / 开源 LLaMA 2/3 / Qwen  对齐成标配,DPO 等简化 RLHF
早期 GPT-3 已展现 in-context learning:在 prompt 里给几个例子,模型就能模仿任务格式。但 可靠性、安全性、助手人格 仍不足,直到 InstructGPT 系统化 人类反馈对齐 后,才出现今天熟悉的 ChatGPT 体验。理解这条时间线,你会明白:并非单靠某次架构突破,而是预训练与对齐数据工程层层叠加的结果。
预训练(Pretraining) 的目标可以一句话概括:给定已经出现的 token 序列,预测下一个 token 是什么。
形式化地,自回归语言模型在 token 序列 上优化:
每个位置都在问:「根据上文,下一个词最可能是什么?」模型通过数十亿次这样的预测,从数据里压缩出语法、常识、推理模式与各种文体。

预训练语料通常包括:
原始语料体积以 TB 级存储 计,训练前往往要经过 过滤 pipeline:去重(MinHash / exact dedup)、语言识别、质量分类器(剔除 spam、成人内容、乱码页)、PII 脱敏等。你下载的 开源 base 模型 已经完成了这一整套;个人 SFT 只需关心 千级 JSONL 是否干净。
GPT-3 使用了约 3000 亿 token 级别的数据;更大模型的数据量与算力继续 scaling。Qwen3.5 等 2025–2026 年的基座,预训练 token 数与多语言比例通常 高于 GPT-3 时代,但 对齐阶段的数据与标注 仍是产品差异化的核心。你不需要记住具体数字,只需建立直觉:预训练是在「模仿互联网上的写法」,而不是在「模仿客服手册里的答法」。
GPT、LLaMA、Qwen 等生成式 LLM 多采用 Decoder-only Transformer(仅解码器)。与前一篇 AI 入门中的 self-attention 一致:每个 token 通过**因果掩码(causal mask)**只能看见自己和之前的 token,从而支持从左到右逐 token 生成。

原始文本不会直接喂进神经网络,而是先经 分词器(Tokenizer) 切成 token。常见算法有 BPE(Byte Pair Encoding) 与 SentencePiece。中文往往一个字或多个字对应一个 token;英文常见子词切分。词表大小通常在 32K–128K 之间。
分词影响训练效率与「一个汉字算几个 token」的成本。做本地微调时,max_seq_length 限制的就是 token 数,不是字符数。
例子:「国立台湾师范大学」在 Qwen 分词下可能是 4–8 个 token 不等。一条 512 汉字的中文回答,可能占用 700–900 token。设置 max_seq_length=2048 时,绝大多数师大 QA 不会截断;若你加入超长招生简章式回答,才需要提高上限或截断数据。
预训练 倾向于:
预训练 不保证:
Temperature 与 sampling 影响的是 推理阶段 随机性,不能替代对齐。高 temperature 的 base 模型只会 更创意地胡说;instruct 模型则在 对齐行为 基础上调节多样性。微调改变的是 条件分布 本身,而不只是采样噪声。
因此,ChatGPT 的体验 = 预训练能力 + 对齐后的行为。你本地微调,是在 对齐链路的最后一环 再加一层 领域 specialization。
Kaplan、Hoffmann 等人的 Scaling Laws 表明:在足够大的数据与算力下,参数量、数据量、计算量与模型 loss 之间存在可预测的幂律关系——更大通常更强,但边际收益递减。Chinchilla 等工作进一步指出:给定固定算力,模型大小与训练 token 数应配平,许多早期模型其实 训得不够 token 或 参数量过大。这些结论指导工业界在预训练阶段 烧算力的方式;对个人而言,只需记住:我们站在巨人肩膀上,用 LoRA 改行为,而不是重新烧预训练。
训练 GPT-4 级别模型需要数千张 GPU、数月时间与数千万美元量级成本,这是工业界与学术实验室的分水岭。
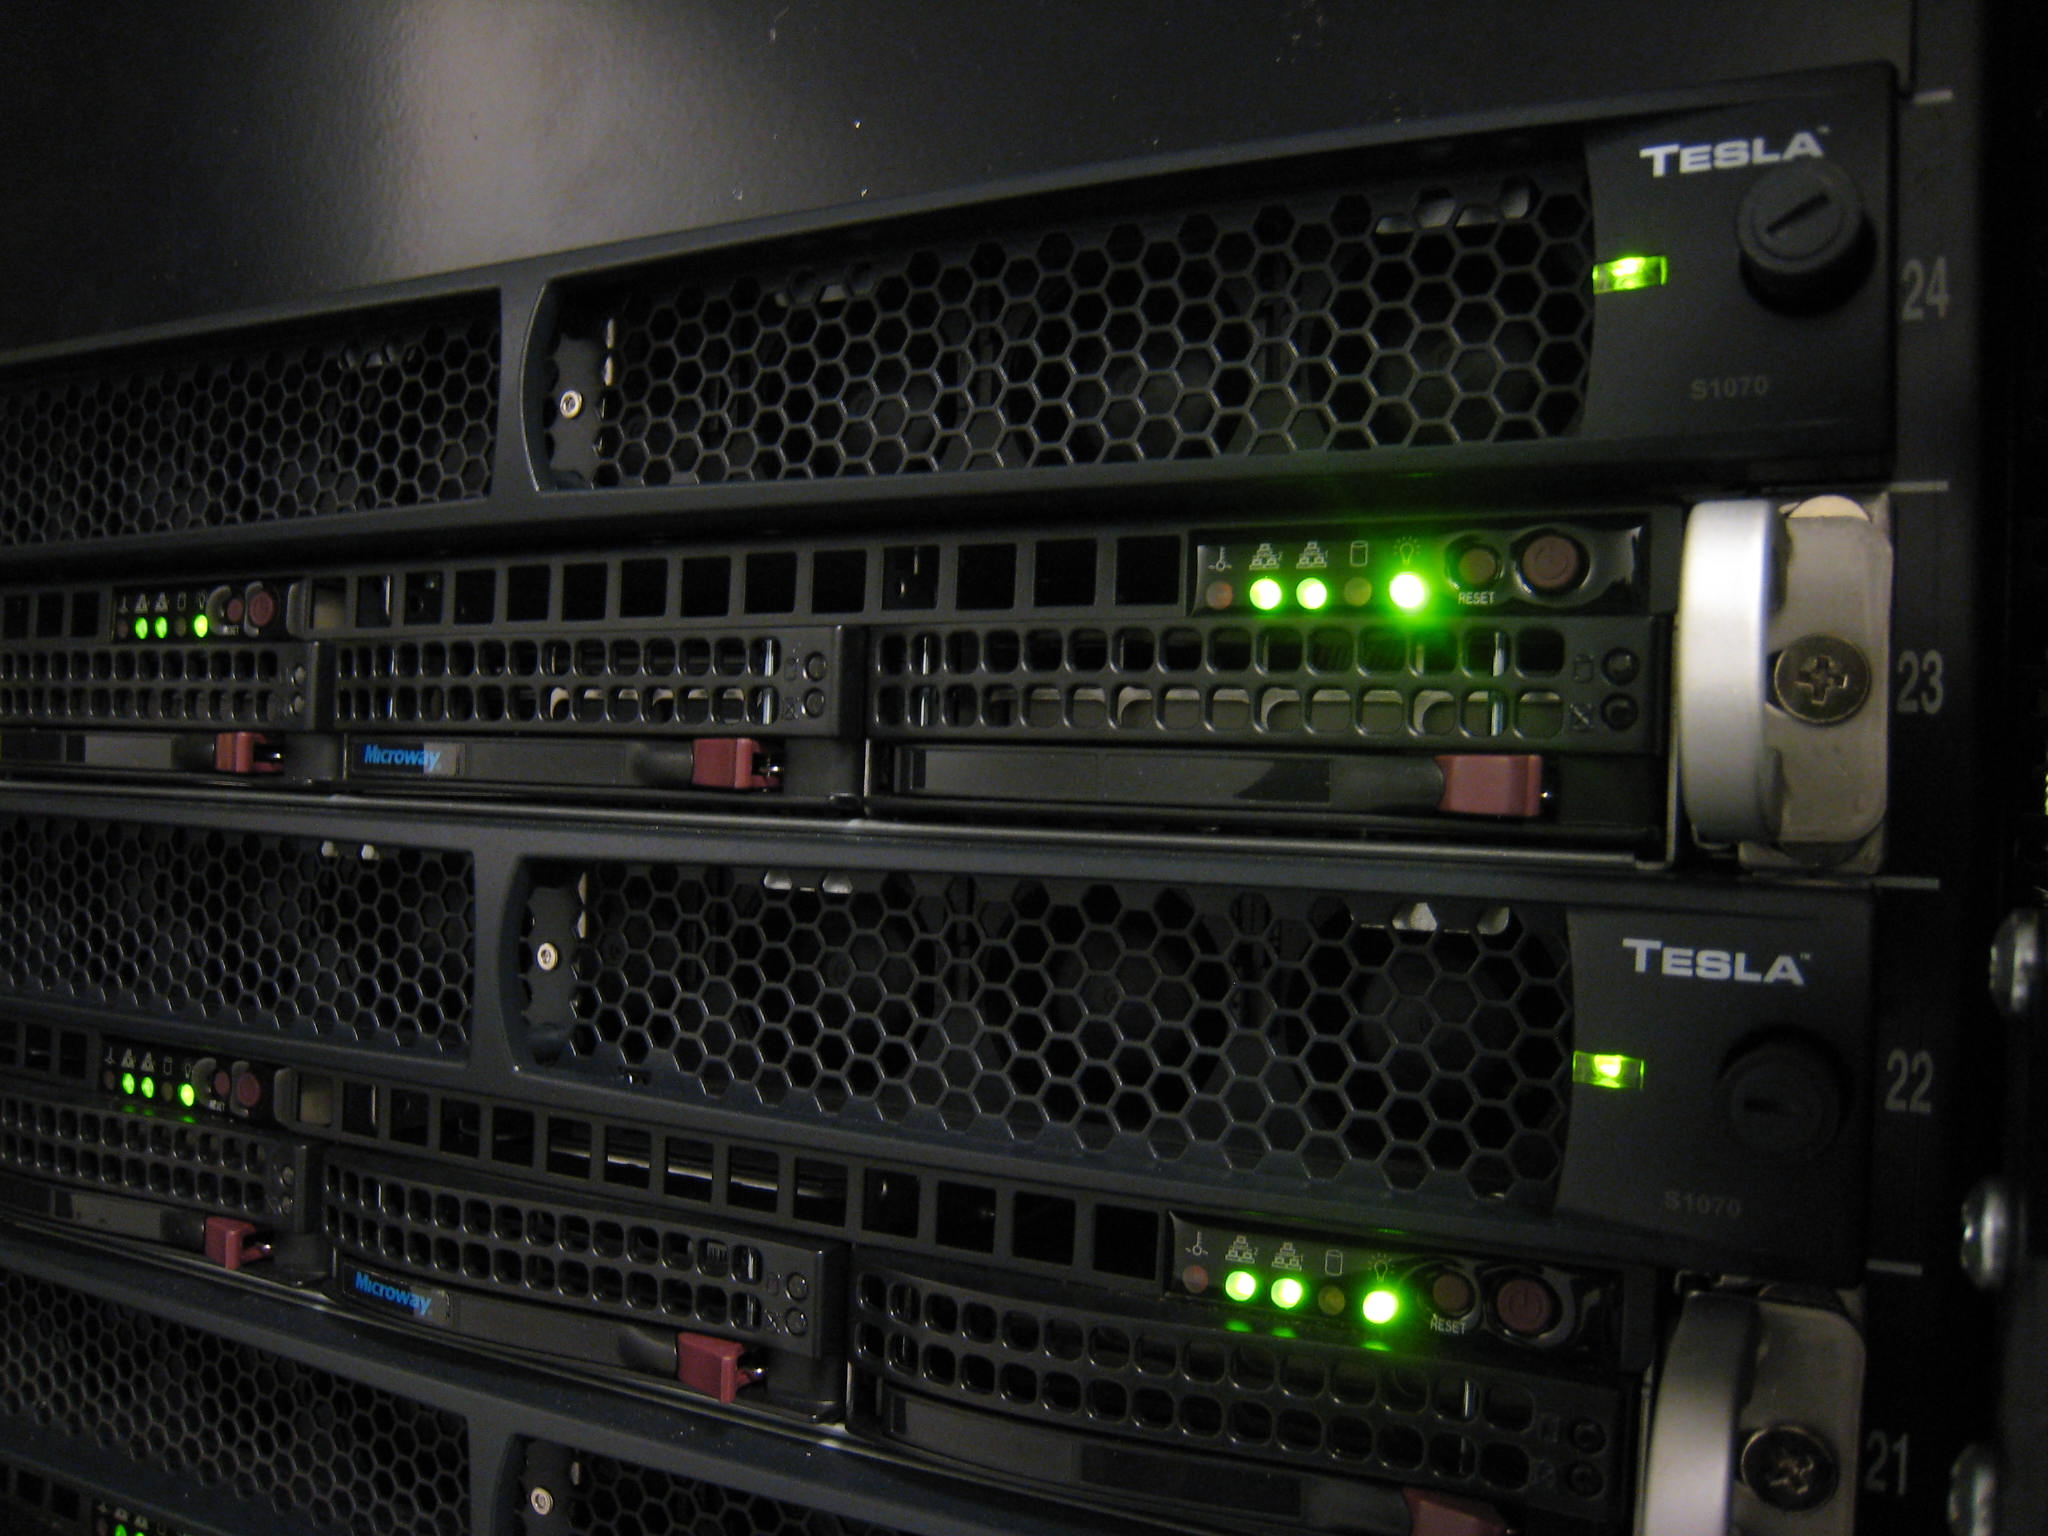
对个人开发者而言,预训练不现实;在已有基座模型上做 SFT / LoRA 才是可行路径——也正是本文后半部分要做的事。
预训练模型已经「会语言」,但用户要的是 instruction-following(遵循指令):你问它问题,它答你,而不是接着你的句子写下去。ChatGPT 界面里的 多轮对话,在训练数据里被显式构造成 user/assistant 角色;模型因此学会 在合适的位置停下,而不是无限续写——这也是 SFT 与 raw completion 的关键差异之一。
监督微调(SFT) 的做法是:收集大量 (用户问题, 理想回答) 对,让人类训练师(或高质量标注流程)写出「好答案」,然后继续用交叉熵损失训练模型,让它模仿这些示范。

在 ChatML 等多轮格式里,一条样本常包含 user 与 assistant 消息。SFT 通常 只在 assistant 回复的 token 上计算 loss,user 部分 mask 掉——因为我们要学的是「怎么答」,不是「怎么问」。
OpenAI 的 InstructGPT 论文展示了一个反直觉的结果:1.3B 参数的 InstructGPT 在人类评估中优于 175B 的 GPT-3 base。参数少两个数量级,但因为做了 SFT + RLHF,更对齐人类意图。这说明:对齐有时比 raw scale 更重要(至少在「当助手」这个任务上)。
对 企业落地 的启示是:不必盲目追逐最大 base 模型;在 7B–13B instruct 模型 + 领域 LoRA 上,很多垂直场景(校内问答、内部规章、客服话术)已能达到可用质量,且 推理成本 远低于调用 frontier API。本文 4B QLoRA 更是 消费级 GPU 可复现 的下限参考——先在小模型上验证数据与 eval,再考虑放大模型或上云训练。

工业界与开源社区常见格式:
| 格式 | 结构 | 典型用途 |
|---|---|---|
| ChatML | messages: [{role, content}, ...] |
Qwen、OpenAI 兼容 API |
| Alpaca | instruction + input + output |
指令微调数据集(如 Dolly) |
| 纯 text | 已渲染好的单字符串 | 自定义模板 |
fine-tuning-playground 默认 ChatML,与 Qwen 原生模板一致。
工业界 SFT 数据来源包括:
本文 ntnu_dataset.jsonl 属于 结构化事实 + 模板化 paraphrase 的合成路线:保证实体一致性与问法多样性,适合教学。生产环境还应加入 人工审核 与 时效性维护(院系改名、排名年份更新等)。
Qwen 的 chat template 会把 messages 渲染成带特殊 token 的字符串,例如概念上类似:
<|im_start|>user
請簡單介紹國立臺灣師範大學。
<|im_start|>assistant
國立臺灣師範大學,簡稱臺師大……
SFTTrainer 读入的是渲染后的 整段 text,模型做 causal LM:预测每个 token,但 loss mask 确保 不惩罚 user 段上的预测误差(由 TRL / template 内部处理)。你在 inference.py 里用同一 tokenizer 的 apply_chat_template(..., add_generation_prompt=True),才能保证 训练与推理格式一致——这是微调最容易踩的坑之一。
SFT 教模型「示范长什么样」,但示范无法覆盖所有情况。同一个问题,可以有很多「语法正确、内容相关」的回答,哪一个更好?更简洁?更诚实?更安全?
奖励模型(Reward Model,RM) 学习的是:给 (prompt, response) 打一个标量分数 ,分数越高表示人类越偏好该回答。
训练数据来自 人类比较:标注员看到同一 prompt 下的多个模型输出,进行排序或 pairwise 选择(A 比 B 好)。常用 Bradley-Terry 模型建模偏好概率:
其中 是胜出(winning)回答, 是落败(losing)回答, 是 sigmoid。

RM 通常 与策略模型共享 Transformer backbone,把语言建模头换成 标量输出头。初始化常来自 SFT checkpoint,以便理解「什么样的文本像助手回复」。
在 InstructGPT 流程中,标注员看到 同一用户问题 与 多个模型生成的回答(可能来自不同 checkpoint 或不同 sampling 温度)。任务不是写新答案,而是 比较哪个更好——有时允许并列。这些比较构成 稀疏但高信息密度 的监督:每条标注同时约束两个回答的相对排序。
奖励模型训练完成后,不会直接给用户用;它只在 RL 阶段当 打分器。若 RM 有偏见(例如偏好更长回答),RL 后的策略也会继承该偏见——这是 RLHF 需要持续 eval 与 RM 迭代 的原因。

有了 RM,就可以把它当作 强化学习中的 reward 信号,进一步微调 策略模型(policy)——也就是最终给用户生成文本的那个 LLM。
RLHF 常用 PPO(Proximal Policy Optimization):
KL 项的直觉:RM 只是人类偏好的 近似,不完美。若 RL 阶段让策略跑太远,可能学会 讨好 RM 但语义崩坏(例如重复高分短语)。KL 惩罚 把策略拴在 SFT 附近,在对齐与能力之间折中。
PPO 本身还有 clip 机制限制单步更新幅度,避免 reward 噪声导致训练发散。完整 RLHF 工程涉及 reward model ensemble、在线数据刷新、安全过滤器 等,远超个人项目范畴;理解「RM 打分 → 策略梯度 → KL 约束」这条主线即可。

对齐不免费。Alignment Tax(对齐税) 指:强对齐有时会在某些 raw benchmark(如纯知识问答、代码题)上略微牺牲分数,换取更好的指令遵循与安全性。是否接受这种 trade-off,取决于产品目标。
工业界也在探索 DPO(Direct Preference Optimization)、ORPO、RLAIF(AI 反馈替代人类) 等,跳过显式 RM + PPO,降低 pipeline 复杂度。ChatGPT 的具体实现未公开,但公开论文与开源生态(LLaMA-2、Mistral 等)都指向 SFT + 偏好优化 已是标配。

| 阶段 | 数据 | 目标 | 产出 | 典型成本 |
|---|---|---|---|---|
| 预训练 | 万亿 token 级网页/书/代码 | 下一个词预测 | Base LM | 极高(集群 × 月) |
| SFT | 万–百万级人工示范 | 模仿好答案 | Instruct 模型 | 高(标注 + GPU) |
| RM | 人类排序/比较 | 预测偏好 | Reward Model | 高(标注) |
| RLHF | RM 提供 reward | 优化策略 | 对齐助手 | 中高(RL 不稳定) |
对你我这样的个人开发者:完整 RLHF 门槛很高;但 SFT / LoRA / QLoRA 在单卡 GPU 上完全可行,且能解决大量「领域知识 + 固定答法」需求——下文实作章节即属此类。
| 变体 | 要点 |
|---|---|
| RLAIF | 用强模型代替人类做偏好标注,降低成本 |
| Constitutional AI | 用原则性文本指导 self-critique 与修订(Anthropic) |
| DPO / ORPO | 直接用偏好对优化策略,省略显式 RM + PPO |
| Continued Pretraining | 在领域语料上继续预训练,再 SFT——适合专业术语极多的领域(法律、医学) |
ChatGPT 的确切配方未公开,但 「base → instruct → preference optimization」 已是 2023 年后开源与闭源产品的共识路径。你本地做的 NTNU SFT,相当于这条链路上的 instruct 阶段的一个子集。
把预训练模型直接当聊天机器人用,往往会遇到一类系统性问题:它很会「接着写」,但不一定会「照着办」。
预训练的目标函数是 语言建模,不是 任务完成。模型学到的是:「这段文字后面通常接什么」。当你输入「请用三句话介绍台湾师范大学」,预训练倾向可能包括:

SFT 明确教它:看到 user 消息,应生成 assistant 角色的、针对问题的回复。RLHF 进一步教它:在多种合法回复里,人类更偏哪一种风格与长度。
在不做对齐的情况下,常见表现包括:
| 问题 | 表现 |
|---|---|
| 答非所问 | 解释概念而不是执行指令(「写代码」→ 讲编程史) |
| 冗长 | 无法收敛到用户要的篇幅 |
| 语气不稳定 | 同一会话里 formal / 口语 / 角色扮演 混用 |
| 幻觉 | 流畅但错误的事实(「师大有五个校区」) |
| 缺少助手人格 | 不像「帮你办事」,像「随机抽一段网页」 |
越狱(jailbreak) 类 prompt 试图让模型 忽略安全策略(例如「假装你是 DAN」)。对齐模型在 RL 数据里见过大量 拒答示范,但仍可能被 novel attack 突破——这是 持续红队 + 更新对齐数据 的原因。个人微调若 不加安全样本,可能让模型 更愿意照单全收 用户指令,部署到公网前务必评估。

这些不全是「模型笨」,而是 训练目标与用户期望不一致。
假设用户输入:
用户:台湾师范大学有几个校区?请简要说明。未经对齐的 base 模型 可能续写为:
……该校办学规模庞大,在国内外享有盛誉。以下介绍其历史背景:国立台湾师范大学的前身可追溯到 1922 年……它把输入当成 文章开头,继续写「百科体」长文,甚至 不先回答「几个校区」。
经 SFT 的 instruct 模型 更可能直接:
台湾师范大学共有三个校区:和平校区(校本部)、公馆校区、林口校区。其中……这就是 任务格式对齐 的价值:同样的知识可能存在于预训练权重里,但 输出行为 需要对齐数据来激活。
预训练模型在 不确定 时仍会采样出 plausible 文本——语法正确、语气连贯,但 事实错误。这在开放域尤其危险:用户会把 confident tone 误判为 reliable。SFT 可以通过示范 「不知道就说不知道」 来部分缓解;RLHF 可以 penalize 胡编。但 没有任何阶段保证事实 100% 正确,这就是为什么 RAG、工具调用与人工审核在产品里仍重要。
对齐指让模型行为符合 人类意图与价值观。OpenAI 常用 HHH 框架概括助手目标:

SFT 主要解决 格式与任务类型(怎么像助手一样说话);RLHF / 偏好优化主要解决 在多种合法回答里选更好(更简洁、更安全、更讨喜)。两者缺一不可地构成了 ChatGPT 类产品与 raw base model 的体验差距。
当你下载 Qwen3.5-4B-Instruct 时,厂商通常 已做过大规模 SFT,部分还有 RLHF/DPO。你在其上做 NTNU LoRA,属于 第三次 specialization:
Qwen 预训练 → Qwen Instruct 对齐 → 你的 NTNU LoRA若从 非 instruct 的 base 训练,你等于 自己承担更多格式对齐工作;数据里就要包含 更多「怎么答」的示范,而不只是 raw 事实。教学仓库允许两种起点;建议初学者 优先 instruct 基座 + 领域 JSONL。
对齐也在 对抗性使用 下持续演进:用户通过 jailbreak prompt 试图绕过安全策略。这说明对齐不是一次训练就永久完成,而是 数据、策略、评估迭代 的长期工程。个人做领域 SFT 时虽不涉及完整安全栈,但应意识到:微调会改变模型行为边界,数据集里有什么语气与内容,模型就会倾向什么。
在进入本地实作之前,先把「有哪些微调手段」摆清楚。个人开发者几乎总是在 已有基座模型 上动手,而不是从零预训练。
本文实作使用 Qwen/Qwen3.5-4B——阿里巴巴 Qwen 团队发布的开源权重,已在万亿级 token 上预训练,并通常附带 基础 instruct 版本(如 Qwen3.5-4B-Instruct)。fine-tuning-playground 默认从 base 或 instruct checkpoint 加载后再加 LoRA;在已有 instruct 模型上继续 SFT 往往 收敛更快,因为模型已经「像助手」了,你的数据只需 注入领域事实。若从纯 base 开始,则需要更多 epoch 或数据来同时学格式与知识。
Qwen 类 decoder 中,注意力层 q_proj/k_proj/v_proj/o_proj 负责 上下文混合;MLP 层 gate_proj/up_proj/down_proj 负责 特征变换。fine-tuning-playground 默认 七层全开,在 4B 上取得较好适配;若 OOM,可只训 attention 四层,牺牲部分表达能力换内存。rank r=16、alpha=32(alpha 约为 2r)是社区常见起点:r 越大,可训练容量越大,也越容易过拟合小数据集。
Full Fine-tuning 更新模型的 全部权重。优点是能最大程度适应新任务;缺点是:
适合有充足算力、数据量大(万级以上高质量样本)、且需要深度改造模型的团队。
LoRA(Low-Rank Adaptation)(Hu et al., 2021)冻结基座权重 ,只训练低秩分解 ,其中 ,,。
推理时:,或把 adapter 合并进权重。可训练参数通常只占 0.1%–1%,却能在许多任务上接近全参效果。

QLoRA(Dettmers et al., 2023)把基座权重量化为 4-bit NF4,在 GPU 上反量化计算;LoRA adapter 仍用 bf16/fp16 训练。这使得 6–8 GB VRAM 即可微调 4B 级模型——RTX 3060 / 4060 / 4070 都能跑。

fine-tuning-playground 默认 QLoRA + 7 个线性层 LoRA target(Q/K/V/O 与 MLP 的 gate/up/down),在 4B 规模上兼顾效果与内存。
| 方法 | 改什么 | 成本 | 适合 |
|---|---|---|---|
| Prompt Engineering | 不改权重,改输入 | 最低 | 快速验证、通用任务、少样本 |
| RAG | 检索外部知识再生成 | 中(索引 + 推理) | 知识常更新、需引用来源 |
| SFT / LoRA | 改(部分)权重 | 中(GPU + 数据) | 固定领域、固定格式、离线部署 |
| RLHF / DPO | 偏好优化 | 高 | 产品级助手、安全与风格 |

过拟合 是 SFT 最常见坑:训练 loss 下降、eval loss 上升,模型「背答案」但不会泛化到新问法。缓解手段包括:更少 epoch、更大 test_split、数据增强问法、LoRA rank 不要过大。
学习率与 epoch:小数据集(如 1.2K)常用 lr 、epoch 2–3;数据量到 30K+ 时往往 减少 epoch 防过拟合(fine-tuning-playground README 有表格)。
在小数据集上 全参微调 容易 灾难性遗忘:模型学会师大 FAQ,却变笨了算术或英文。LoRA 因 大部分权重冻结,遗忘风险 显著低于 full FT,但并非为零——若 lr 过大、epoch 过多,仍可能损害通用能力。缓解:降低 lr、减少 epoch、在数据里 掺 5–10% 通用 instruct 样本(alpaca 子集)做 混合训练。fine-tuning-playground 未默认混合,但生产环境常见。
训练保存的是 LoRA adapter;推理时 inference.py 用 PeftModel.from_pretrained(base, adapter_path) 合并逻辑加载。--load_in_4bit True 与训练一致可省 VRAM。若要把 adapter 合并进全量权重 导出单文件,可用 PEFT 的 merge_and_unload()——便于部署到 不支持 PEFT 的运行时,但失去「一个小 adapter 多任务切换」的灵活性。
理论讲完,下面 动手。我用作者维护的教学仓库 fine-tuning-playground:单文件 src/train.py、CLI 驱动、内置 ntnu_dataset.jsonl(约 1,252 条国立台湾师范大学 ChatML 问答),目标是在本地让 Qwen3.5-4B 更可靠地回答师大相关问题。
整个实作 不修改 基座权重文件本身;训练产物是 LoRA adapter 目录,可随时删除重训,风险可控。这也是个人玩微调相比 full FT 的 另一大优点:实验迭代快,磁盘占用小。
仓库另有
data/taiwan/universities.jsonl、districts.jsonl、geography.jsonl等扩展集;更换--dataset_path即可复用同一 pipeline。本文聚焦 bundled 师大集,降低首次上手复杂度。
技术栈:
| 包 | 作用 |
|---|---|
transformers |
加载 Qwen3 / Qwen3.5、分词器 |
peft |
LoRA / QLoRA 配置 |
trl |
SFTTrainer 监督微调 |
bitsandbytes |
4-bit 量化 |
datasets |
加载 JSONL |


硬件参考(QLoRA 4B):
| 配置 | 最低 VRAM | 典型 GPU |
|---|---|---|
| batch 1–2 | ~6–8 GB | RTX 3060 / 4060 / 4070 |
| batch 2, seq 2048 | ~12 GB | RTX 3060 12GB / 4070 |
无 CUDA 时会 自动降级 CPU + float32,仅适合 smoke test,4B 全精度极慢。
每条记录是一个 JSON 对象,含 messages 数组(ChatML)。示例(繁体原文与仓库一致):
{
  "messages": [
    {"role": "user", "content": "請簡單介紹國立臺灣師範大學。"},
    {"role": "assistant", "content": "國立臺灣師範大學,簡稱臺師大、師大或 NTNU,是臺灣第一所師範大學……"}
  ]
}
英文问法同样存在,例如 "What is National Taiwan Normal University?",有助于模型 双语回答 同一实体。
数据主题覆盖:历史沿革、三校区(和平、公馆、林口)、九大学院、国语教学中心(MTC)、国际排名、交通地址、知名校友等。问法多样,避免模型只记住单一模板。部分回答含 排名年份、QS/THE 分数 等时变信息——部署到生产前应 核对时效;教学实验则重在观察 格式与实体是否对齐数据,而非排名数字是否最新。


构造流程(仓库 data/ 下脚本):结构化事实 → 多模板 paraphrase 问法 → 合并为 JSONL → generate_ntnu_dataset.py 可聚合子目录。教学时可直接用 bundled 文件,不必自己标注 1,252 条。
约 1,252 条记录中,问法涵盖 中文简繁、英文、简称(师大、NTNU)、细节追问(地址、排名、学院) 等。train.py 默认 test_split=0.05、seed=42,即约 63 条 eval、1,189 条 train。Trainer 在 eval loss 最优时 load_best_model_at_end,避免最后一轮过拟合。
你可以用下面命令快速统计本地 JSONL 行数:
wc -l data/ntnu_dataset.jsonl
python -c "import json; print(sum(1 for _ in open('data/ntnu_dataset.jsonl',encoding='utf-8')))"师大实体 边界清晰(一所学校、三校区、公开信息多),适合验证微调是否 注入结构化知识。同一 pipeline 可换成你关心的 内部文档 QA、产品手册、API 说明——关键是 问答对质量与覆盖面,而非主题本身。
Python 3.11 或 3.12 推荐(CUDA wheel 兼容性好)。
git clone https://github.com/cw1997/fine-tuning-playground.git
cd fine-tuning-playground

conda create -n finetune python=3.11 -y
conda activate finetune
pip install -r requirements.txt
Windows 可用 PowerShell:powershell -File scripts/install_deps.ps1;Git Bash 与 Linux 相同。
验证 GPU:
python -c "import torch; print(torch.cuda.is_available(), torch.version.cuda)"应输出 True 与 CUDA 版本号。若为 False,检查驱动与 PyTorch CUDA 构建是否匹配。
bash scripts/train_preset.shtrain_preset.ps1;环境变量用 $env:DATASET_PATH=...dataset_path 本地路径需以 ./ 或 / 开头,否则会被当作 Hugging Face Hub 数据集名首次安装 bitsandbytes 在 Windows 上偶有问题;仓库 README 建议 Python 3.11 + CUDA cu128 wheel。若 4-bit 加载失败,可暂时 --load_in_4bit False 并 --device cpu 做逻辑验证(勿用于完整 4B 训练)。
第一步:Smoke test(1 epoch,确认 pipeline 通)
bash scripts/train_preset.sh smoke-4bWindows PowerShell:
powershell -File scripts/train_preset.ps1 -Preset smoke-4b第二步:完整训练(12 GB GPU + 4B + 默认师大集,3 epoch)
bash scripts/train_preset.sh gpu-12gb-4b等价手动命令:
python src/train.py \
  --model_id Qwen/Qwen3.5-4B \
  --dataset_path ./data/ntnu_dataset.jsonl \
  --device gpu \
  --load_in_4bit True \
  --torch_dtype bfloat16 \
  --max_seq_length 2048 \
  --num_epochs 3 \
  --per_device_batch_size 2 \
  --gradient_accum_steps 8 \
  --learning_rate 2e-4 \
  --lora_r 16 --lora_alpha 32 \
  --lora_dropout 0.05 \
  --warmup_ratio 0.03 \
  --test_split 0.05 \
  --logging_steps 10 \
  --save_steps 200 \
--output_dir ./models/ntnu/gpu-12gb-4b| 参数 | 含义 | 调参提示 |
|---|---|---|
model_id |
Hugging Face 模型名 | 推理时必须与训练一致 |
load_in_4bit |
QLoRA 量化 | OOM 时先降 max_seq_length |
lora_r / lora_alpha |
LoRA 秩与缩放 | 小数据 r=16 常用;大数据可试 32 |
learning_rate |
峰值学习率 | 1.2K 样本默认 2e-4 |
test_split |
验证集比例 | 0.05 → 按 eval_loss 存 best checkpoint |
gradient_accum_steps |
梯度累积 | 有效 batch = batch_size × accum |
有效 batch size 预设约为 16(如 batch 2 × accum 8),适合小数据集稳定训练。
阅读 src/train.py 时可按此顺序对照:
text 字段;可选 train/test splitoutput_dir核心 LoRA 与 Trainer 配置如下(摘自仓库,略有删节):
model = get_peft_model(
    model,
    LoraConfig(
        r=args.lora_r,
        lora_alpha=args.lora_alpha,
        lora_dropout=args.lora_dropout,
        target_modules=target_modules,
        bias="none",
        task_type="CAUSAL_LM",
    ),
)

trainer = SFTTrainer(
    model=model,
    processing_class=tokenizer,
    args=SFTConfig(
        output_dir=args.output_dir,
        num_train_epochs=args.num_epochs,
        learning_rate=args.learning_rate,
        gradient_checkpointing=True,
        load_best_model_at_end=eval_dataset is not None,
        metric_for_best_model="eval_loss",
        dataset_text_field="text",
        max_length=args.max_seq_length,
    ),
    train_dataset=train_dataset,
    eval_dataset=eval_dataset,
)
trainer.train()
trainer.save_model(args.output_dir)
load_training_datasets 中对 ChatML 的处理:每条 messages 经 tokenizer.apply_chat_template(..., tokenize=False) 转成单一字符串,供 SFTTrainer 做 causal LM loss。
train.py 默认 gradient_checkpointing=True:用 重算激活 换 更低显存,训练会略慢但 4B QLoRA 在 8GB 卡上更稳。Windows 上 dataloader_num_workers=0 避免多进程 spawn 问题;Linux 可用 2 workers 略提速。
若你修改 dataset_format=alpaca,需保证 JSON 含 instruction/output 字段;text 格式则适合 已渲染好的 多轮字符串。师大实验 stick to chat 即可。

训练完成后,output_dir 内主要是 LoRA adapter 权重(体积通常远小于完整模型),以及 tokenizer 配置。
在 RTX 4070 12GB 量级 GPU 上,1,252 样本 × 3 epoch、seq 2048、有效 batch 16,完整 run 往往 在 数十分钟到一两小时 之间,取决于 GPU 型号、磁盘与是否首次下载模型。smoke-4b(1 epoch)通常在 十分钟左右 可完成,适合验证环境。
日志中关注:
Train examples: 1189, eval: 63
{'loss': 1.85, 'learning_rate': ..., 'epoch': 0.12}
...
{'eval_loss': 1.42, ...}
train_loss 与 eval_loss 同步下降 通常是健康信号;若 train 继续降而 eval 回升,考虑 提前停止 或 减少 epoch。
微调前(基座模型):
python src/inference.py --mode base --model_id Qwen/Qwen3.5-4B \
  --prompt "台灣師範大學的地址是什麼" --no_interactive
微调后(加载 adapter):
python src/inference.py --mode finetuned --model_id Qwen/Qwen3.5-4B \
  --adapter_path ./models/ntnu/gpu-12gb-4b \
--prompt "台灣師範大學的地址是什麼" --no_interactive并排对比:
python src/inference.py --mode compare --model_id Qwen/Qwen3.5-4B \
  --adapter_path ./models/ntnu/gpu-12gb-4b \
  --prompt "請簡單介紹國立臺灣師範大學" --no_interactive
预期现象:基座模型可能对「师大」实体 泛化不足或幻觉地址;微调后更倾向输出数据集中常见的 和平东路一段 162 号、三校区、MTC 等结构化事实。这不是「模型变聪明了」,而是 行为被领域数据塑形。

省略 --no_interactive 时进入 交互循环,可持续提问测试;--use_thinking 可启用 Qwen3 思考链模板(本数据集默认关闭)。
若你训练出满意的 LoRA,可用:
python src/train.py \
  --dataset_path ./data/ntnu_dataset.jsonl \
  --output_dir ./models/ntnu/my-run \
  --push_to_hub True \
  --hub_model_id your-username/qwen-ntnu-lora
需要先 huggingface-cli login。上传的是 adapter + tokenizer 配置,使用者仍需基座 Qwen/Qwen3.5-4B 加载合并。这与 全量模型开源 不同,但 分享成本低、下载快,适合课程作业或团队内共享实验。
仓库 data/generate_ntnu_dataset.py 可聚合 data/ntnu/ 与 data/taiwan/ 下多份 JSONL(大学、行政区、地理等)。更换训练路径示例:
python src/train.py \
  --model_id Qwen/Qwen3.5-4B \
  --dataset_path ./data/taiwan/universities.jsonl \
  --output_dir ./models/tw-universities \
  --device gpu
或指向整个目录递归加载所有 .jsonl。本文聚焦 ntnu_dataset.jsonl 以保持实验 可复现、易评估;你掌握 pipeline 后,换数据即是 同一套代码、不同领域 specialization。
CUDA OOM
--max_seq_length(2048 → 1536 → 1024)--per_device_batch_size 1,增大 gradient_accum_steps 保持有效 batch--target_modules q_proj,k_proj,v_proj,o_proj(仅 attention 层 LoRA)过拟合
--num_epochs--test_split(如 0.10)eval_loss数据集规模指引(README 摘要)
| 样本量 | Epoch | LR | 备注 |
|---|---|---|---|
| < 500 | 3–5 | 1e-4 | 过拟合风险高 |
| ~1.2K(师大集) | 3 | 2e-4 | 预设默认值 |
| 5K–30K | 2–3 | 1.5e-4–2e-4 | 可试 lora_r=32 |
| 30K+ | 1–2 | 1.5e-4 | 避免过多 epoch |
Windows 若显存碎片导致 OOM,可设:
export PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True在宣称「微调成功」之前,建议逐项确认:
torch.cuda.is_available() 为 True(GPU 训练)output_dir 内存在 adapter 权重(非空目录)inference.py --mode compare 在 至少 5 个 held-out 问法 上优于 base若 eval_loss 最低点的 checkpoint 不在最后一轮,确认 load_best_model_at_end=True 已生效;推理时使用 该 checkpoint 对应目录 或 trainer 自动加载的 best 权重,避免 用最后一轮过拟合权重 做 demo。完整训练日志可重定向到文件便于事后排查:bash scripts/train_preset.sh gpu-12gb-4b 2>&1 | tee train.log。
走完原理与实作,回到更 general 的问题:什么时候值得微调?数据越多越好吗?「更像人」是否「更正确」?
可以用 学生成长 类比(仅为直觉,非严格对应):
| 阶段 | 类比 | 模型层面 |
|---|---|---|
| 预训练 | 读大量书籍与网页 | 学会语言、事实片段、代码、文体 |
| SFT | 做习题并对照标准答案 | 学会「用户问 → 助手答」格式与任务类型 |
| RM | 老师比较两份作文孰优 | 学会什么是「更好」的回答 |
| RLHF | 根据评分调整写作习惯 | 在多种合法回答中偏向高 reward |
预训练解决 「知不知道怎么说」;SFT 解决 「听不听得懂指令、会不会按示范答」;RLHF 解决 「在都对的情况下哪个更讨人喜欢、更安全」。
个人领域微调(如本文 NTNU)通常 只做 SFT 已足够——因为你主要注入 事实与固定叙述风格,而非重塑全局偏好。产品级 ChatGPT 则四段齐全。
可以把四层看成 叠加 而非 互相取代:
RLHF 偏好层     ← 哪种答法更好、更安全
SFT 任务层      ← 怎么像助手一样答
预训练知识层    ← 语言与广泛事实
(可选)RAG 外挂 ← 动态、可引用的事实
本地 NTNU 实验动的是 SFT 任务层 + 部分知识层(师大事实)。若师大招生简章 每年更新,仅靠 SFT 权重无法自动更新——应 重训数据 或 RAG 接官网。
机器学习老话:Garbage in, garbage out。微调尤其敏感:

InstructGPT 论文也强调:标注质量与标注者培训 是对齐的关键成本。开源社区常见失败案例:用低质 Alpaca 翻译数据 SFT,模型 格式像助手、内容胡编——量很大,但「好」不足。
实践建议:
反例:把同一 FAQ 复制粘贴 5000 次只能让 loss 降得「很快」,模型却 不会 因此更会回答新问法——它只是记住了 重复模式的统计。好数据的核心是 覆盖 + 正确 + 多样,而不是单纯堆行数。

优先 Prompt Engineering 当:
Prompt 工程的成本在于 长 system prompt 占用 context 窗口、每次推理重复发送、以及 不同模型对 prompt 敏感度不同。当 prompt 长到数千 token 仍无法稳定输出格式时,就该认真考虑 SFT 把格式 bake 进权重。
值得 SFT / LoRA 当:
值得 RAG 当:
三者 可组合:RAG 检索 + 小模型 SFT 学「怎么根据检索结果回答」是常见企业架构。
成本粗算:一次 4B QLoRA 完整 run 电费加折旧通常 可忽略于个人实验;人力成本主要在 数据整理与 eval。相比之下, frontier API 按 token 计费,在 高 QPS、长 prompt 场景下,小模型 + LoRA 部署可能在 数月内回本——但前提是你的任务 不需要 frontier 级推理,且 维护数据与模型版本 的成本可接受。
没有银弹;很多团队 先 prompt 原型 → RAG 接文档 → 最后 LoRA 固化高频场景。
不一定。 RLHF 优化的是 人类偏好,不是 客观真值。
典型现象:

评估应 双轨:
本文 NTNU 实验里,微调提升的是 与数据集一致的事实复述,不是 general reasoning。若数据集本身有错,模型会 更坚定地错——这是 SFT 的风险,再次说明 好数据 优先于 多数据。
DPO(Direct Preference Optimization) 把 RLHF 里的 RM + PPO 简化为 在偏好对 上直接优化策略,隐式对应某个最优 reward。优点:实现简单、训练更稳定;缺点:仍依赖高质量偏好数据。Meta LLaMA 2/3、许多开源对齐模型采用 SFT + DPO 组合。作为读者,你应知道 RLHF 不是唯一对齐手段,但 「从示范到偏好」的两级监督 这一思想是共通的。
产品级模型还会在 SFT 与 RL 数据中加入 拒答示范(如何礼貌拒绝有害请求)与 红队测试(adversarial prompt)。个人 NTNU 微调虽不涉及,但若你的领域 bot 会面对公众,应在数据里 明确哪些话不能说,否则 base 模型的安全行为可能被 领域数据覆盖。
| 术语 | 英文 | 一句话 |
|---|---|---|
| 预训练 | Pretraining | 下一个词预测,学语言与常识 |
| 监督微调 | SFT | 模仿人类示范问答 |
| 人类反馈强化学习 | RLHF | 用 RM + RL 优化偏好 |
| 低秩适配 | LoRA | 只训小矩阵,冻结基座 |
| 量化 LoRA | QLoRA | 4-bit 基座 + LoRA,省 VRAM |
| 检索增强生成 | RAG | 先查文档再生成 |
| 对齐 | Alignment | 行为符合人类意图与安全 |
| 幻觉 | Hallucination | 流畅但事实错误 |
| 对齐税 | Alignment Tax | 对齐后部分 benchmark 下降 |
README.zh-Hant.md)如果你跟着本文跑通了 smoke test 和完整训练,下一步可以尝试:换
data/taiwan/universities.jsonl做台湾大学校问答、调lora_r与 epoch 观察 eval_loss、或把 adapter 推到 Hugging Face Hub 分享。微调不是魔法,而是 用高质量数据塑形模型行为 的工程;理解预训练与 RLHF 在全链路中的位置,你会更清楚自己这一步 SFT 究竟在解决什么问题。
| 你想做的事 | 建议 |
|---|---|
| 理解 ChatGPT 怎么训出来 | 预训练 → SFT → RM → RLHF |
| 解释 base 模型为何不像助手 | 补全目标 ≠ 指令遵循 |
| 在 6–8GB GPU 上注入领域知识 | QLoRA + fine-tuning-playground |
| 知识常变、要 citation | RAG,或 RAG + 轻量 SFT |
| 只改语气、通用任务 | Prompt / 换 instruct 模型 |
| 评估微调效果 | compare 模式 + held-out 人工检查 |
大语言模型时代,训练决定能力上限,对齐与数据决定产品体验,而你的 SFT 数据集决定小模型在 niche 领域能有多可靠。 把这三层分开想,就不容易陷入「再训一个大模型」或「数据越多越好」的误区了。建议你把本文当作 地图,把 fine-tuning-playground 当作 练车场——先跑通完整流程,再谈优化与实际上线部署。
最后一句收束:预训练让模型读懂世界,SFT 教它如何服务你的场景,RLHF 教它何种服务方式更讨人喜欢;而你要做的,是用千条量级的精心问答,验证 LoRA 是否值得成为你工具链里的一站。 若本文对你有帮助,欢迎 star fine-tuning-playground 并在 issue 里反馈数据或脚本改进建议。